Apple melhora representações 3D latentes na inferência
Artigo aceito no NeurIPS 2026 aplica um tokenizador já treinado a sub-regiões menores da cena e eleva o detalhe sem treinar um modelo maior. O custo migra do treinamento para a inferência, que é divisível.
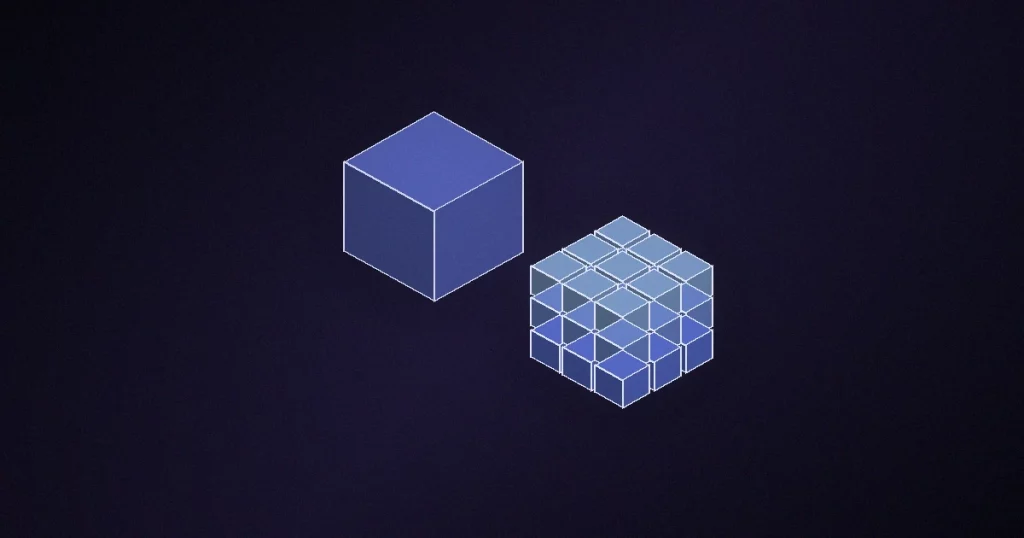
Arte editorial: o mesmo volume dividido em sub-regiões menores.
A Apple publicou em novembro de 2026, em sua página de pesquisa em aprendizado de máquina, o artigo “Split-and-Scale Latent 3D Representations”, aceito para o NeurIPS 2026. O trabalho propõe um caminho para aumentar o nível de detalhe de cenas tridimensionais reconstruídas por redes neurais sem precisar treinar um modelo maior — a escala acontece no momento da inferência, não no treinamento.
O artigo é assinado por Dorian Chan, Muhammed Kocabas, Xiaoming Zhao, Oncel Tuzel e Jen-Hao Rick Chang, e foi submetido ao arXiv em 12 de novembro de 2026 sob o identificador 2611.16126, na categoria de visão computacional. Não há, até o momento, repositório de código ou página de projeto associados à publicação.
O problema que o grupo ataca é conhecido por quem trabalha com geração e reconstrução 3D: as representações 3D latentes comprimem uma cena inteira em um conjunto pequeno de vetores, o que as torna eficientes e adequadas para alimentar modelos generativos, mas também impõe um teto. Quando o objeto tem muitos detalhes finos, a capacidade do espaço latente simplesmente não dá conta.
O que são representações 3D latentes
Em vez de guardar uma malha com milhões de triângulos ou uma nuvem densa de pontos, esses métodos treinam um tokenizador: uma rede que converte a geometria e a aparência de uma cena em um conjunto reduzido de códigos, os chamados latentes. Um decodificador faz o caminho inverso e reconstrói a cena a partir deles. A vantagem é dupla — o formato é compacto e, por ser uma sequência de códigos, pode ser manipulado por arquiteturas generativas, do mesmo jeito que texto é manipulado por modelos de linguagem.
O preço é a perda de detalhe. Quanto mais complexo o objeto, mais informação precisa caber no mesmo orçamento de latentes. A saída óbvia seria treinar um tokenizador com capacidade maior, mas isso esbarra em dois muros: o custo computacional do treinamento e o limite de memória da GPU. Modelos com capacidade latente alta o suficiente para objetos realmente complexos passam do que cabe em uma única placa.
A alternativa aparentemente simples — treinar um modelo normal e, na hora de usar, pedir mais latentes — não funciona. Segundo os autores, aumentar ingenuamente a quantidade de latentes na inferência não faz o modelo aproveitar a capacidade adicional de forma efetiva.
A ideia do split-and-scale
A observação central do trabalho é que, quando a cena é representada como uma função contínua de coordenadas 3D, o tokenizador não está preso à escala em que foi treinado. Ele pode ser aplicado a qualquer região do espaço, inclusive a sub-regiões arbitrariamente pequenas.
Daí o nome. A cena é dividida (split) em pedaços menores, e um único tokenizador pré-treinado é aplicado a cada pedaço. Como o orçamento de latentes passa a cobrir um volume espacial menor, a densidade efetiva de informação sobe: o mesmo número de códigos descreve muito menos espaço, e portanto descreve esse espaço com muito mais detalhe. A capacidade total escala (scale) com o número de sub-regiões, sem que nada precise ser retreinado.
O ponto economicamente interessante é onde o custo se desloca. Treinar continua barato, porque o tokenizador é o mesmo de antes. O custo extra vai para a inferência, e inferência é divisível: cada sub-região pode ser processada separadamente, o que mantém o pico de memória sob controle. É assim que o método, segundo o artigo, alcança qualidade competitiva com modelos muito maiores — modelos que não caberiam na memória de uma única GPU.
O que o artigo relata
- Estudos de ablação extensos mapeando as trocas entre computação, memória, capacidade latente e qualidade de reconstrução. É essa parte que sustenta a afirmação principal, mostrando que o ganho não vem de um ajuste pontual.
- Qualidade competitiva com modelos muito maiores que excedem o limite de memória de uma GPU única, usando escala em tempo de inferência.
- Aplicação generativa: os autores treinaram um gerador 3D autorregressivo sobre a representação split-and-scale e relatam desempenho competitivo com as melhores linhas de base da área.
Uma ressalva honesta de leitura: o material público — a página da Apple e o resumo no arXiv — descreve os resultados em termos comparativos, sem divulgar as métricas numéricas. Os valores de reconstrução, os conjuntos de dados usados e as linhas de base específicas estão no texto completo do artigo, e qualquer afirmação quantitativa fora dele seria especulação. O trabalho foi aceito no NeurIPS 2026, o que indica revisão por pares, mas não dispensa a leitura dos números por quem for depender deles.
Onde isso pode ser útil
A linha de pesquisa tem aplicação direta em captura e geração de ativos 3D para realidade aumentada e virtual, games, comércio eletrônico com visualização de produto, efeitos visuais e simulação. Em todos esses casos existe a mesma tensão: o ativo precisa ser detalhado o suficiente para convencer e leve o suficiente para ser transmitido e renderizado em tempo real.
Para a Apple especificamente, a pesquisa se encaixa em um histórico recente de trabalhos voltados a representações 3D eficientes — a empresa já havia publicado, em outubro, um método de animação de avatares 3D em tempo real, que cobrimos aqui. A convergência de interesse é previsível em uma companhia que mantém uma plataforma de computação espacial, mas vale lembrar que publicação acadêmica não é anúncio de produto, e nada no artigo indica incorporação a um sistema comercial.
Limitações e o que ainda não se sabe
Alguns pontos ficam em aberto e merecem atenção de quem considerar usar a técnica.
- O custo não desaparece, muda de lugar. Economizar no treinamento ao preço de uma inferência mais cara é vantajoso quando o modelo é treinado uma vez e usado muitas, mas é desfavorável em cenários de uso massivo e sensível a latência.
- Divisão espacial cria fronteiras. Processar sub-regiões independentes levanta a questão clássica de continuidade nas junções. O resumo público não detalha como o método trata emendas entre blocos vizinhos.
- Sem código público. Não há repositório associado, o que atrasa a verificação independente e a adoção prática.
- Ausência de afiliação explícita no arXiv. Embora o artigo esteja hospedado na página de pesquisa da Apple, a submissão não lista vínculos institucionais dos autores.
Conclusão
O split-and-scale é um bom exemplo de uma tendência que atravessa a pesquisa em IA neste momento: em vez de empurrar todo o ganho para modelos maiores e treinamentos mais caros, extrair mais capacidade do que já existe, no momento da execução. É a mesma lógica que apareceu em modelos de linguagem com escala em tempo de inferência, aplicada agora a representações geométricas.
O que acompanhar daqui para frente: a apresentação no NeurIPS 2026 e os números completos do artigo, a eventual liberação de código que permita replicação, e se o método se sustenta em cenas grandes e abertas — e não apenas em objetos isolados, que é onde a maioria dos tokenizadores 3D costuma ser avaliada.
Fontes e referências
- Apple Machine Learning Research — “Split-and-Scale Latent 3D Representations”: machinelearning.apple.com
- Dorian Chan, Muhammed Kocabas, Xiaoming Zhao, Oncel Tuzel, Jen-Hao Rick Chang — “Split-and-scale Latent 3D Representations”, arXiv:2611.16126 (12/11/2026), aceito no NeurIPS 2026: arxiv.org/abs/2611.16126
- Plugged Ninja — “Apple anima avatares 3D em tempo real a 196 FPS no iPhone”: plugged.ninja