Apple treina rede para acelerar a busca vetorial do RAG
Dois modelos treinados antes do uso aprendem a rotear consultas e a prever a chave ótima de um índice vetorial. No conjunto Natural Questions, o ganho chega a oito vezes em tempo de busca — desde que a base e o perfil das perguntas sejam estáveis.
A Apple Machine Learning Research publicou em 5 de novembro de 2026 um resumo técnico de um trabalho que ataca um gargalo pouco visível dos sistemas de geração aumentada por recuperação, os chamados RAG: o tempo gasto para encontrar, dentro de uma base com milhões de trechos de texto, qual deles melhor responde à pergunta do usuário. A proposta troca uma heurística geométrica por uma rede neural treinada antes do uso.
O trabalho está descrito no artigo “Amortizing Maximum Inner Product Search with Learned Support Functions”, de Theo X. Olausson (MIT, com o trabalho realizado durante passagem pela Apple), João Monteiro, Michal Klein e Marco Cuturi, apresentado na ICML 2026 e disponível como preprint no arXiv sob o identificador 2603.08001.
Os números reportados são expressivos: em um índice IVF da biblioteca FAISS, o maior dos modelos atinge 99% de recuperação em 0,23 milissegundo, contra 1,8 milissegundo da consulta original — cerca de oito vezes mais rápido. Antes de tratar isso como ganho universal, convém entender exatamente a condição que o método exige, porque ela é restritiva.
O gargalo da busca vetorial em sistemas RAG
Em um pipeline de RAG, a pergunta do usuário e os trechos de documento são convertidos em vetores. Escolher o trecho mais relevante equivale a encontrar o vetor da base cujo produto interno com o vetor da pergunta é o maior possível — problema conhecido como busca pelo máximo produto interno, ou MIPS, na sigla em inglês. O mesmo mecanismo sustenta sistemas de recomendação e buscadores.
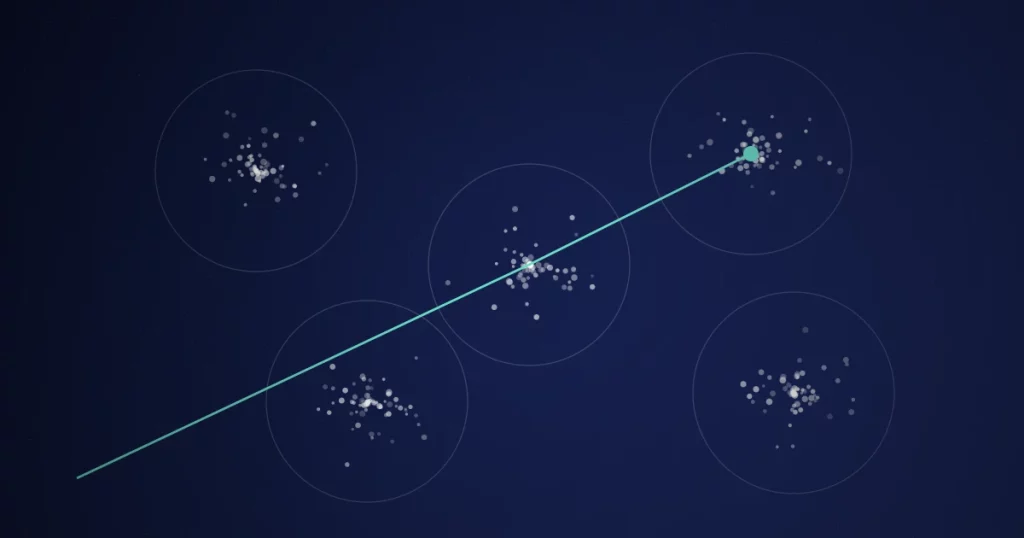
Como comparar a pergunta com todos os vetores da base é caro, a prática padrão agrupa os vetores em partições e calcula um representante para cada grupo, o centroide. A consulta é então roteada para a partição cujo centroide está mais próximo, e só os vetores daquela partição são examinados em detalhe. É rápido, mas falha quando o melhor candidato está em uma posição distante do centroide do seu próprio grupo.
O argumento central dos autores é que essa abordagem ignora uma informação disponível de graça: a distribuição das consultas. Em RAG, as perguntas são curtas e têm formato previsível, enquanto os trechos indexados são longos e curados. São distribuições diferentes, e o roteamento por centroide trata ambas como se fossem o mesmo tipo de objeto.
SupportNet e KeyNet: aprender a função suporte
A observação matemática que sustenta o método é que a função que devolve o melhor valor possível de produto interno para uma consulta é a função suporte do conjunto de chaves. Essa função é convexa, positivamente homogênea de grau 1, e seu gradiente aponta justamente para a chave ótima. Em termos práticos: se for possível aproximar bem essa função, a resposta da busca sai da própria derivada.
A partir disso, os autores apresentam dois modelos, treinados uma única vez por base fixa, usando consultas de exemplo pareadas com suas respostas exatas:
- SupportNet — aproxima a função suporte de cada partição com uma rede neural convexa na entrada, em versão com restrições relaxadas. Produz uma pontuação por partição e roteia a consulta para a de maior pontuação. O treinamento combina regressão da pontuação, casamento de gradiente e invólucros que impõem a homogeneidade de grau 1. Segundo a Apple, as pontuações saem calibradas, o que permite usá-las também para reordenar candidatos ou aplicar limiares.
- KeyNet — pula a etapa de derivada e prevê diretamente o vetor da chave ótima. É treinado com uma perda de consistência derivada do teorema de Euler para funções homogêneas. Na prática, funciona como um reescritor de consulta colocado na frente de um índice IVF convencional, sem exigir mudança no mecanismo de busca.
Os modelos foram avaliados em quatro tamanhos — XS, S, M e L —, correspondentes a 1%, 5%, 10% e 20% do tamanho da base, todos com 16 camadas. O custo, portanto, não é desprezível: o modelo maior ocupa um quinto do espaço da própria base que ele indexa.
Os números: até oito vezes mais rápido no índice IVF
A avaliação principal usa o conjunto Natural Questions, com cerca de 2,6 milhões de trechos únicos, particionado em 128 grupos. A Apple afirma que a tendência se manteve em outros conjuntos de dados, sem nomeá-los no resumo; o artigo relata avaliação em benchmarks BEIR com embeddings de documentos.
No roteamento com o SupportNet:
- O modelo pequeno alcança 95% de recuperação de roteamento cerca de 1,9 vez mais rápido que o roteamento por centroide — 1,74 milissegundo contra 3,36.
- O modelo grande chega a 97% de recuperação no mesmo 1,74 milissegundo.
- Examinando 5% da base, os roteadores aprendidos acertam a partição correta em 90% a 93% dos casos, chegando a 92,6% no modelo M, contra 87,5% do roteamento por centroide.
Na busca com o KeyNet sobre índice IVF do FAISS:
- A 99% de recuperação, o maior modelo é até cerca de oito vezes mais rápido: 0,23 milissegundo contra 1,8 da consulta bruta.
- Examinando 0,001% da base, as consultas reescritas recuperam a chave correta em 89% a 97% dos casos, com 96,7% no modelo L, contra 86% da consulta original.
- Para atingir 99% de recuperação, é preciso examinar até cerca de 11 vezes menos chaves: 0,009% da base contra 0,10%.
Vale a leitura cuidadosa dessas comparações. Os ganhos de tempo são medidos contra o roteamento por centroide e contra a consulta não reescrita no mesmo índice, não contra o conjunto de todas as técnicas de busca aproximada disponíveis. O artigo mede o custo em três unidades diferentes — operações de ponto flutuante, número de partições examinadas e tempo de parede — o que é um cuidado metodológico acima da média nessa literatura.
Onde o método se aplica e onde não se aplica
As duas condições de uso estão declaradas e são decisivas. O treinamento acontece offline e depende de conhecer previamente a distribuição das consultas e de operar sobre uma base de chaves fixa. Isso serve bem a um assistente interno de documentação, a uma base de conhecimento de suporte ou a um catálogo estável, em que as perguntas se repetem em padrões reconhecíveis e o acervo muda em janelas controladas.
Serve mal, por construção, a cenários de base viva. Um índice que recebe documentos novos a cada hora obriga a reavaliar o modelo treinado, e o resumo da Apple afirma robustez razoável a desvios leves na distribuição das consultas sem apresentar evidência detalhada desse ponto — é uma afirmação a verificar, não um resultado a assumir. Também há o custo de amortização: alguém precisa gerar o conjunto de treinamento com as respostas exatas, o que significa rodar a busca completa muitas vezes antes de economizar na busca.
Existe, por outro lado, um desdobramento interessante levantado pelos autores: se um modelo relativamente pequeno consegue prever a chave ótima para uma distribuição conhecida de consultas, abre-se caminho para comprimir a base de forma orientada ao uso real, guardando menos do que o acervo completo. Isso ainda é uma direção apontada no artigo, não um resultado demonstrado.
Conclusão
O trabalho não promete um RAG melhor em qualidade de resposta — ele trata de custo e latência na etapa de recuperação, que costuma ser invisível no debate público sobre modelos de linguagem e é justamente onde muitas implantações corporativas travam. Trocar uma regra geométrica fixa por uma função aprendida sobre a distribuição real das perguntas é uma ideia que se encaixa bem nos casos em que o acervo é estável.
O que observar a seguir são reproduções independentes fora dos conjuntos usados pela Apple, medições em bases que mudam com frequência e comparações diretas com índices baseados em grafos de proximidade, hoje o padrão de fato em boa parte dos sistemas de produção. Até que isso apareça, o resultado vale como avanço bem documentado em um nicho específico.
Fontes e referências
- Apple Machine Learning Research — “Faster Retrieval for Better, More Efficient RAG”, 5 de novembro de 2026 — machinelearning.apple.com
- Apple Machine Learning Research — “Amortizing Maximum Inner Product Search with Learned Support Functions”, Theo X. Olausson, João Monteiro, Michal Klein e Marco Cuturi, ICML 2026 — machinelearning.apple.com
- arXiv — preprint do artigo, identificador 2603.08001 — arxiv.org
- FAISS — biblioteca de busca por similaridade usada nos experimentos, com documentação do índice IVF — github.com/facebookresearch/faiss
- BEIR — conjunto de benchmarks de recuperação de informação citado no artigo — github.com/beir-cellar/beir
- Natural Questions — conjunto de dados de perguntas e respostas usado na avaliação principal — ai.google.com