Memória de agentes de IA falha e decide por prova social
Pesquisadores publicaram em 27 de outubro de 2026 um benchmark que isola quem detém cada evidência numa discussão entre modelos de linguagem. O resultado contraria duas heurísticas usadas para resumir o debate e mostra que remover a autoria dos fatos eleva o acerto em até 24 pontos.
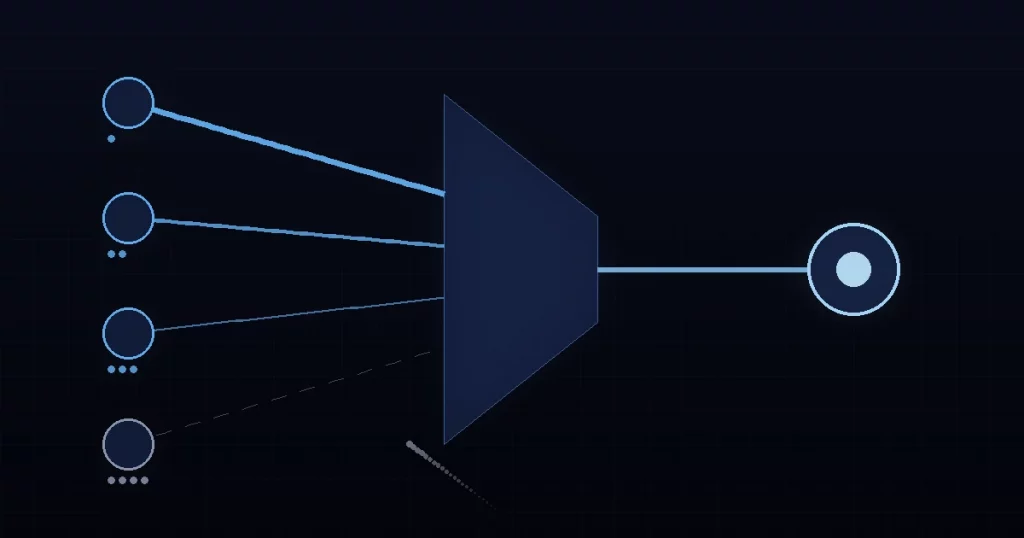
Arte editorial original sobre falhas na memória de agentes de IA em decisões de grupo.
Quando vários modelos de linguagem discutem um problema e o histórico dessa conversa precisa ser comprimido em um resumo curto para que um último modelo decida, qual informação o resumo deve guardar? Um preprint publicado no arXiv em 27 de outubro de 2026 testa as duas respostas mais intuitivas — guardar o que poucos disseram, ou guardar o que é relevante para o critério de decisão — e mostra que as duas erram de maneira previsível.
O trabalho, intitulado Rare, Relevant, and Still Wrong: How Memory Fails LLM Group Decisions, é assinado por Anouar Imel, Imad Charradi, Abderrahman Sghir e Khalil El Khammar. O preprint não declara afiliação institucional dos autores. Ele introduz o CrossProfile, um benchmark de diagnóstico desenhado para separar duas coisas que, nos testes anteriores, andavam sempre juntas: se um fato é raro e se um fato é útil.
O achado mais chamativo não está nas políticas de memória de agentes de IA, e sim no comportamento do modelo que decide. Ele dá peso extra a fatos atribuídos a muitos agentes — um equivalente artificial da prova social. Remover as etiquetas de autoria do resumo, sem mudar uma palavra do conteúdo, elevou a taxa de acerto em até 24,4 pontos percentuais em um dos modelos testados. O tema dialoga diretamente com o que o Plugged Ninja cobriu recentemente sobre consolidação de memória em modelos de linguagem: aqui a questão não é como consolidar, mas o que a consolidação destrói.
Contexto: a tarefa do “perfil oculto”
O desenho experimental vem da psicologia social. Em 1985, Stasser e Titus descreveram as tarefas de perfil oculto: cada participante recebe apenas parte das informações, e a combinação dessas partes aponta para uma resposta diferente daquela que cada um escolheria sozinho. Grupos humanos falham nessas tarefas porque discutem sobretudo o que todos já sabem. Gigone e Hastie documentaram em 1993 o efeito de conhecimento comum: a informação detida por mais membros pesa mais no julgamento coletivo, independentemente de sua qualidade.
Esse arcabouço foi adaptado a grupos de modelos de linguagem pelo HiddenBench, de Li, Naito e Shirado, que avaliou divulgação forçada, sumarização passiva e comunicação estruturada entre agentes. O problema metodológico que o novo trabalho aponta é que, no HiddenBench, raridade e utilidade estão confundidas: os fatos que sustentam a resposta correta tendem a ser justamente os privados. Guardar o mais raro acerta — mas não porque a raridade seja um bom critério, e sim porque, naquele arranjo, raro e útil coincidem.
Como o CrossProfile isola as variáveis
O benchmark tem 60 modelos de tarefa principais, cinco em cada um de 12 domínios de decisão. Cada modelo de tarefa tem quatro agentes, três opções e 12 fatos, divididos em três papéis:
- cinco fatos de apoio, que favorecem a opção correta, incluindo evidência negativa sobre a opção isca;
- três fatos isca (decoys), que favorecem a opção concorrente — e aqui está o detalhe importante: são afirmações verdadeiras cuja implicação parcial é enganosa, e que também tratam do critério declarado de decisão;
- quatro fatos irrelevantes, sobre outros atributos, de tom positivo ou negativo.
A intervenção central é que o texto dos fatos permanece fixo enquanto a posse de cada grupo de papéis é variada: cada grupo pode ser compartilhado por todos ou privado de um agente, o que gera oito variantes de posse e 480 tarefas derivadas. Dez modelos-piloto são excluídos de todas as estimativas principais. O gabarito é mecânico: cada fato favorável soma um ponto à sua opção, cada desfavorável subtrai um, irrelevantes valem zero, e um verificador automático confere em cada modelo de tarefa se existe uma única melhor opção considerando todos os fatos.
As políticas de memória comparadas, todas sujeitas a um orçamento de tamanho, são: R1, que ordena as afirmações por número crescente de contribuintes (o mais raro primeiro); B4, que ordena por primeira aparição; Random, ordem aleatória; B3, um resumo que pede ao modelo preservar cada evidência distinta com suas condições, incertezas e discordâncias; e R1-rel, que primeiro pede ao modelo apontar quais textos tratam dos critérios declarados e usa isso como primeiro nível de prioridade, mantendo a ordem R1 dentro de cada nível.
Configuração experimental
Os autores usaram Qwen2.5-7B-Instruct e Llama-3.1-8B-Instruct servidos localmente com vLLM em precisão fp16, contexto de 8.192 tokens e três sementes (17, 42 e 91). Decisões, sumarizações e extração de afirmações rodaram com temperatura zero; as mensagens de discussão natural usaram temperatura 0,7, top-p 0,9 e até 256 tokens de saída. Além desses, dois modelos hospedados foram avaliados pela API da DeepSeek com o modo de raciocínio desativado: o DeepSeek-V4.1-Flash nos 60 modelos de tarefa do CrossProfile e o DeepSeek-V4-Pro em 30 deles. O HiddenBench contribuiu com 65 tarefas.
Os três modos de falha da memória de agentes de IA
1. A raridade é uma aposta sobre quem guarda as iscas. Na média, guardar primeiro o mais raro não é melhor do que a ordem aleatória. A política só ganha nas configurações de posse em que os fatos raros são, por coincidência, os úteis. O que determina o acerto é o saldo de evidências entre as opções que o resumo deixou, não a regra que o produziu.
2. Relevância readmite as iscas. Na média, priorizar por relevância ajuda: ganhos de 8,5 pontos no Qwen, 15,6 no Llama e 16,7 no DeepSeek-V4.1-Flash. Mas essa média esconde uma perda grande em um arranjo específico — o chamado caso clássico, com fatos de apoio privados, iscas compartilhadas e fatos irrelevantes privados. Nele, a política de raridade atinge 96,7% de acerto no Qwen e 97,2% no Llama, e a priorização por relevância derruba isso em 22,2 e 20,0 pontos respectivamente. A razão é estrutural: as iscas tratam do critério de decisão, portanto são relevantes por definição, e um filtro de relevância perfeito continua deixando-as entrar.
3. O modelo que decide segue a prova social. Esta é a parte mais inesperada. Os autores testaram uma memória que contém todos os fatos — sem orçamento, sem seleção. Nessa condição a opção correta tem dois pontos de vantagem em todas as variantes, de modo que um leitor indiferente à posse acertaria igualmente em qualquer arranjo. Não é o que acontece: o acerto é 21,0 pontos mais alto no Qwen e 13,8 no Llama quando os fatos de apoio são compartilhados em vez de privados. No caso clássico, a memória com todos os fatos chega a apenas 54,4% e 55,6% — cerca de 40 pontos abaixo da memória construída a partir dos mesmos fatos sob orçamento de 60%.
A causa está nas etiquetas: cada linha da memória começa com a identificação dos agentes que afirmaram aquilo. Sem as etiquetas, a vantagem dos fatos compartilhados cai de 21,0 para 7,2 pontos no Qwen e de 13,8 para 7,6 no Llama. E removê-las eleva o acerto no caso clássico em 14,4 pontos no Qwen, 13,3 no Llama e 24,4 no DeepSeek-V4.1-Flash, que sai de 72,8% para 97,2%. Reatribuir as etiquetas aleatoriamente, mantendo a ordem das linhas, produz efeito semelhante — ou seja, o que atrapalha é a atribuição, não a posição do fato no texto.
O gargalo que nenhuma memória resolve
Há um resultado que reposiciona todo o problema. Quando os agentes discutem livremente, em vez de receberem inventários estruturados, nenhuma política de memória se mostra mensuravelmente melhor que outra — e o motivo aparece antes de qualquer memória ser construída: a evidência nunca chega à conversa.
Nas discussões naturais do HiddenBench (65 tarefas, 195 discussões por modelo), o voto final do grupo após duas rodadas acerta em apenas 23,6% dos casos no Qwen, 31,8% no Llama e 24,6% no DeepSeek-V4.1-Flash. A transcrição completa da conversa leva a um acerto menor do que uma memória vazia nos três modelos: 22,1% contra 33,8% no Qwen, 33,8% contra 36,9% no Llama e 25,6% contra 35,9% no Flash. Os mesmos modelos chegam a 70,3%, 61,5% e 89,7% quando recebem todos os fatos diretamente. E uma verificação por casamento de texto encontrou os fatos privados enunciados integralmente em apenas 1,7% das discussões do DeepSeek-V4.1-Flash.
A leitura é incômoda e direta: na deliberação livre, a informação privada simplesmente não é dita. Nenhuma estratégia de resumo recupera um fato que nunca foi enunciado.
Impactos, possibilidades e limitações
Para quem constrói sistemas multiagente em produção, há três implicações práticas. A primeira é que resumos de deliberação não devem ser otimizados por prevalência nem por tópico, mas pelo saldo de evidências que deixam entre as opções. A segunda é que apresentar “quantos agentes afirmaram X” como se fosse força da evidência é ativamente prejudicial quando as fontes não são independentes — e, em sistemas em que agentes leem o que os outros escreveram, elas quase nunca são. A terceira é que avaliar o resumo sem avaliar a discussão que o alimentou mede a coisa errada.
O trabalho tem limitações que os próprios dados deixam visíveis. Os modelos abertos testados são de porte pequeno — 7 e 8 bilhões de parâmetros —, e o único modelo grande avaliado em toda a extensão do benchmark é o DeepSeek-V4.1-Flash, com o modo de raciocínio desativado; não se sabe como o raciocínio explícito alteraria a sensibilidade às etiquetas. O CrossProfile é um benchmark sintético e estruturado, com gabarito aritmético, o que dá precisão à medição mas não reproduz a ambiguidade de uma decisão real. E, por ser um preprint recém-submetido, ainda não passou por revisão por pares.
Conclusão
O artigo não anuncia um método novo nem um modelo melhor. Ele faz algo mais incômodo: mostra que duas heurísticas de bom senso usadas para resumir deliberações entre agentes de IA funcionam por coincidência estatística em benchmarks anteriores e falham onde a posse das evidências é variada de propósito. E acrescenta um achado que não dependia da memória: o modelo que decide confunde repetição com evidência.
O que observar a seguir são três coisas: se a versão revisada por pares confirma a magnitude do efeito das etiquetas em modelos maiores e com raciocínio habilitado; se o CrossProfile é adotado por outros grupos como teste de diagnóstico; e se arcabouços de agentes passam a tratar a atribuição de autoria como metadado a ser deliberadamente omitido do contexto de decisão. A licença do preprint é a licença não exclusiva do arXiv, que não autoriza reúso de figuras — a imagem desta matéria é original.
Fontes e referências
- arXiv — Rare, Relevant, and Still Wrong: How Memory Fails LLM Group Decisions (arXiv:2610.37624v1, cs.AI, submetido em 27 de outubro de 2026), por Anouar Imel, Imad Charradi, Abderrahman Sghir e Khalil El Khammar
- arXiv — Versão HTML integral do preprint, com tabelas e apêndices
- arXiv — HiddenBench: Assessing Collective Reasoning in Multi-Agent LLMs via Hidden Profile Tasks, por Li, Naito e Shirado
- PMLR — Systematic Failures in Collective Reasoning under Distributed Information in Multi-Agent LLMs
- Hugging Face — Organização DeepSeek AI, com os cartões dos modelos V4.1-Flash e V4-Pro